导读丨请回答2022——当我们回到生成式AI元年
记者 龚文颖 实习生 崔洪瀚
为什么是2022年?它是一道分水岭——2022年11月,ChatGPT发布,生成式AI推开了人类与AI交互交融的大门。
在此之前,书籍、网页里流淌的,绝大多数是一代代人沉淀下来的人类文化成果。短短几年后,AI写作、AI制图、AI视频走进了工厂、书桌、编辑部、课堂……
站在2026年回头看,我们想向各行各业提出同一个问题:如果把时间拨回2022年,重回浪潮的起点,你最想守护或深耕哪一项人类独有的技能?
图片由AI辅助生成。广西云-广西日报记者 古秀芳 制图
这个故事说来有点荒诞——今年7月,美国调查媒体404 Media披露,图书数据库公司ISBNdb在其官网向AI企业批量兜售2022年前出版的旧书,并提供严格保密协议。报道刊发后,该页面被撤下,公司表示这桩买卖“从未实际成交”。而在后续追踪调查中,媒体记者把一枚AirTag(一款蓝牙智能追踪器)藏进一批稀有二手书里。这批被匿名买家订走的书,一路被运到亚马逊位于拉斯维加斯的仓库。该媒体记者向内部员工打听到了工作流程:切掉书脊、高速扫描,原书随后被销毁。
更早被曝光的还有Anthropic(一家美国人工智能企业,核心产品是Claude系列大语言模型)的“巴拿马项目”。该公司于2024年初斥资数千万美元购入数百万册书,同样在切脊、扫描后毁掉原书。
这种现象引发了广泛争议,各界都在追问:AI公司大量扫描旧书,究竟想要得到什么?
这就要回溯一下“分水岭”的由来了。
正如前文所述,2022年底,生成式人工智能ChatGPT正式推出,标志着大语言模型开始面向大众普及,这被业内称为互联网内容生态中的一道分水岭。
它划分的是“干净语料”和“受污染语料”——在2022年之前,我们在互联网上看到的文本,基本以人类创作为主。此后几年间,海量AI生成内容持续涌入论坛、博客、资讯页面,和人类写作混杂在一起,不断回流成为新模型的训练素材。
AI公司大量搜罗2022年前的纸质书,不仅是因为这些书本身的阅读价值,也因为它们在物理上隔绝了AI的污染——它们出版的时候,AI还在摇篮里。
2024年7月,一篇发表在《自然》杂志的论文提出:当模型反复使用上一代模型生成的数据训练,那些不常见、属于少数派的内容会先消失,模型输出越来越单一,最终退化成单调的模式,于是发生“模型崩溃”。
这个担忧并非空穴来风。近几年AI生成内容的体量在急速膨胀。AI代码审查公司Graphite的追踪研究显示,2024年11月,AI生成文章的数量首次超过了人类撰写的文章,此后占比稳定在五成左右。2025年4月,新加坡软件公司Ahrefs分析了90万个新建英文网页,发现74.2%含有AI生成内容。
保留一部分纯人工文本可以缓解“崩溃”,引发了AI行业对“干净数据”的渴求,这也许能解释AI企业争相搜罗纸质旧书的动因。
一方面,“人类原生文本”变得更有价值,另一方面,创作者越来越依赖AI写作。那么新的问题出现了:我们会不会正在丢掉生产高质量文本的能力?
这里说的“高质量文本”,不单指文学作品,而是各领域的原创内容。
2025年,中国青少年研究中心针对全国7省市的8500余名中小学生进行问卷调查。调查结果显示,超七成受访中小学生用AI辅助完成作业,20.5%的受访中小学生表示想依赖AI思考不想自己思考。为此,研究团队提醒:思考能力是学生成长和发展的关键能力,虽然AI可以启发青少年的思维,但过度依赖AI可能削弱他们独立思考的能力。
无独有偶,2025年,宾夕法尼亚大学等机构在《PNAS Nexus》(《美国国家科学院院刊》子刊)上发表了一项对照研究成果,指出借助大语言模型获取信息、随后自主写作的受试者,对主题的理解更浅,产出的建议篇幅更短、支撑事实较少。研究者解释,大模型直接提供整合后的摘要,减少了用户从原始来源发现和综合信息的步骤,而这些步骤是深度学习的关键环节。
北京师范大学文学院教授张柠也在“花城文学课”节目中指出:如今AI的全面介入,让人们的大脑开始“休假”和“罢工”。当日常生活被算法与自动化工具全方位接管,人类的思维原创力、表达力与共情力正面临严峻挑战。他认为,AI可以高效生成文本,但无法替代人类真挚的情感体验与灵魂深处的独创性表达。
当切割书脊的刀片落下,创作与思考之间的那根“装订线”还在不在?
今年4月,作家刘亮程在社交平台表示,他发现某出版社要编入中学生课外读物的一篇署名“刘亮程”文章并非自己所写,而是AI仿写文。他表示“我的文字来自我所抚摸过的真实世界,AI只抚摸过我的文字。”
同一个月,作家毕飞宇在南宁的阅读分享会上表示:“文学的本质是一个人、一个生命对外部世界的具体感知、概括和表达。AI都不是一个生命,我们这些人怎么可能用它去表达?”
思考能力,它是逻辑推理、批判性分析、创造性思维等能力的集合,在反复求证、自我推翻、权衡取舍的过程中形成。AI生成的文稿可以做到要素齐全、结构工整,但文本背后缺少了创作者的权衡、怀疑与取舍。当我们习惯用技术处理思考,就会慢慢丧失人的核心能力。
但这并不意味着要全盘拒绝AI工具。AI可以作为检索素材、打磨表达、校验错误的助手;真正危险的是把提出问题、辨析证据、形成判断这一核心思考环节交付出去。
切掉书脊,切开的是一本书的物理装订。而一个写作者开始依赖AI生成的那一刻,被切断的正是自身与思考之间那根最后的装订线。
2022,不是一个用来怀念的数字。我们讨论从前、讨论AI,不是为了拒绝席卷而来的新浪潮。就像前人留下来的丰富多彩的文明,我们希望留下感知、创造、判断的能力,在一次次求索、推敲中,创造更多纯净而真诚的、具有时代意义的文明成果。
吴晓
图片由AI辅助生成。
作为《西游记》《红楼梦》的书粉,我始终偏爱原著文字里细腻饱满的故事质感。长久以来,不少影视版本演绎经典,各有各的动人之处,只是受拍摄场景、道具经费、特效水平和镜头叙事的客观条件所限,很难把文字里所有想象空间尽数铺展。AI技术出现后,我似乎发现了古典文化的另一种打开方式。
我心中的AI创作,首先应该是对经典文本的忠实赓续,其次是活化演绎——贴合原著的人物外形、藏在情节之下细腻的内心活动、精准捕捉散落在文字中的细节,把人物的喜怒哀乐、纠结取舍具象落地,稳稳托住中式古典独有的浪漫。
然而,令人心有戚戚的是,近两年来,“魔改”的AI名著短剧走红网络,“圣黛CP”(AI把孙悟空与林黛玉配成情侣)更是在前几个月刷屏。今年1月1日起,广电总局开展了“AI魔改”视频专项治理工作,重点清理基于四大名著、历史、革命、英模题材的魔改视频。《人民日报》《文艺报》等批评了“林黛玉倒拔垂杨柳”“唐僧变黑帮大佬”“诸葛亮飙英语”等乱象,指出对“调侃英雄、解构崇高、颠覆基本认知的恶意篡改,必须划出红线”。
我不禁回望2022年——人工智能浪潮的起点。那时的我,观望这场技术变革,只觉新奇,却未想到,这个新工具如何安放我们对古典名著的喜爱。倘若可以回到那个起点,我最想守住和深耕的元能力是主动创造、主动赋能,依托人独有的思考与创造力,主动驾驭AI、落地创意、解决实际问题。例如,深耕原著文本,逐一拆解影视改编容易忽略的小众桥段、细节伏笔与人物心理,建立专属的古典名著创意素材库;运用AI轻量化、高适配的创作优势,打造高质感的名著系列短剧,配合多语种翻译,让东方奇幻和中式浪漫,以更鲜活、更年轻的姿态走向国际观众。
AI可以执行指令、完成标准化输出,却无法对某个文化传播思路的落地负责。所有价值,都源于人的主导:是人思考出文化传播的痛点,是人构思出经典活化的路径,是人定义AI的使用场景,最终让技术为想法服务、为文化赋能。在技术遍地可得的时代,工具从不稀缺,稀缺的是懂得用思考驾驭工具、用创意激活技术,坚守正确价值取向,驱动AI向善赋能社会的人类智慧。
【作者系国家级青年人才,西部国际传播中心(iChongqing)采编部主任】
丁建军
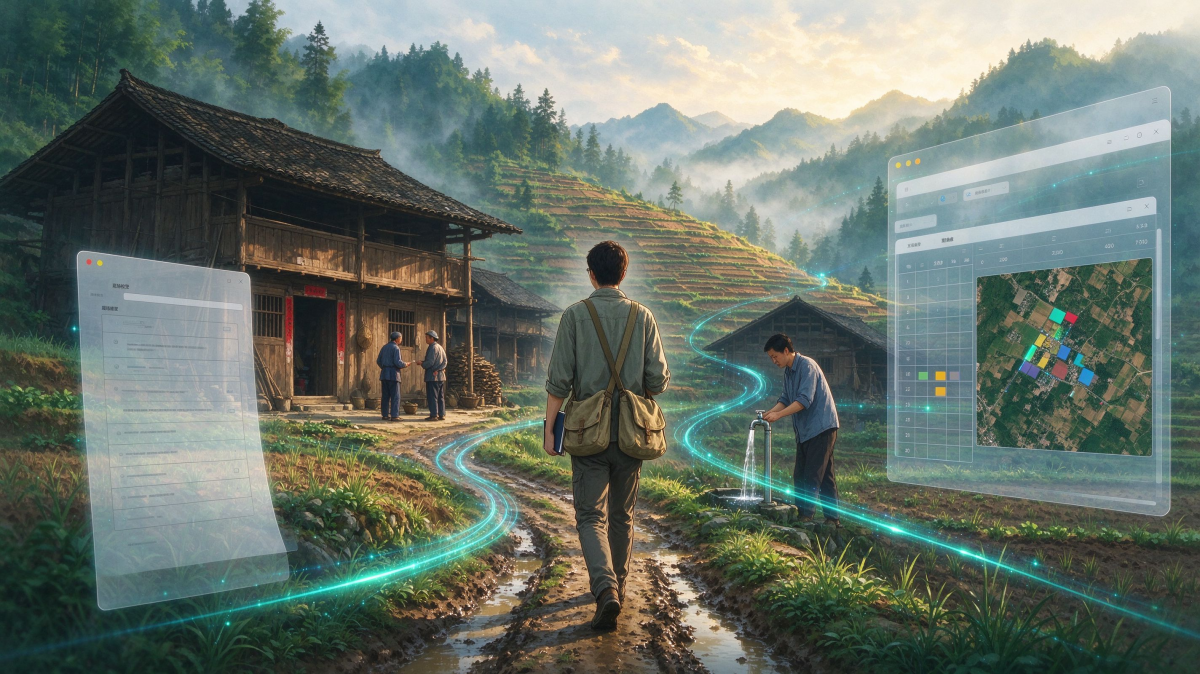
图片由AI辅助生成。
2022年11月,ChatGPT出来的那几天,我正在湘西跑农户调查。朋友圈一片惊呼,我的第一反应是太好了,这些年攒下的问卷、录音、村会计的台账,总算有个不知疲倦的助手帮我整理了。
我这行的判断,大多不是攒出来的,是走出来的。
1999年,我坐了一整天的长途车,从湘南的丘陵进了湘西的大山。此后20多年,我大半时间在武陵山里转。关注的问题也土:这个寨子为什么穷?那块地为什么没人种?一个答案,常常要跑几个村、问十几户,隔年再看,还站不站得住。
2019年,年初那两个月,我基本在路上——贵州的县、广西的县,然后是湖北恩施的县,做贫困县退出第三方评估检查。100多人的队伍,一天跑几个村。入户表上有一栏“是否有安全饮水”。我给评估员提了要求:必须自己拧一下水龙头。
为什么?因为有的院子水管装得整整齐齐,一拧,却不出水——山上水源冻了,或者水压上不去,老人还是得挑水喝。台账上写着“达标”,屋里却没水。只坐在电脑前看那张表,你会看到一个已经脱贫的村子。
卫星影像也一样。图上标着“未耕种”的坡地,被机器判成“撂荒”。人亲自爬上坡,才看见地块碎得像补丁,最陡的地方微耕机都上不去,机耕道修到半山腰就断了。不是农民不愿种,是种不动。
所以AI答得越顺溜,我心里越犯嘀咕。它像个书读得很多却从没在村里住过的年轻人,问什么都能接上话,还答得比村里人整齐。
回到2022年,问我想守住什么,答案是走到现场去。
AI强在它能读的东西——文本、影像、报表,凡是已经留下痕迹的,它都读得比我们快。可最要紧的信息,恰恰是没被记下来的:农户说“过得去”时那半秒钟的停顿,村干部提到某个项目时绕开的某句话,一间屋子里东西摆放的样子。这些填不进表格,也进不了语料库。
更麻烦的是,喂给AI的东西也在变。转述越来越多,句子越来越顺,棱角越来越少。做研究最怕的,就是把“看起来的样子”当成“本来的样子”。
这些年我养成两个习惯:一是带学生下乡,不是急着发问卷,而是在农户家坐下,先听他们聊天;二是先走一遍,再建模型,数据进模型前必须有现场校准。2025年8月,国务院印发《关于深入实施“人工智能+”行动的意见》,提出创新哲学社会科学研究方法。我的理解是把整理、编码、初筛这些力气活交给机器,把判断和到场留给自己。
2022年不是一段值得怀念的黄金时代,我要守的也不是“旧”,而是那句老话——没有调查,就没有发言权。
(作者系湖南科技学院党委委员、副校长、教授,博士生导师)
冯格雅
近年来,全球生成式AI产业保持较快扩张态势,AI数字化服务贸易规模持续走高,而词元服务正逐步成为数字服务贸易的重要组成部分。根据公开数据,国产大模型周度词元调用规模位居全球前列,北美、欧洲、中东、拉美、亚太等区域开发者和中小企业采购需求持续上升。
因此,词元经济作为新型智能经济形态,已经成为各地数字经济竞争的重要新赛道。广西拥有面向东盟的区位优势、“来数加工”试点政策、绿色算力禀赋以及丰富的特色行业应用场景,具备开展跨境词元业务的先天基础。广西应抢抓机遇,建设中国—东盟词元经济创新应用与跨境服务枢纽,推动广西数字经济走出特色化、差异化的发展之路。
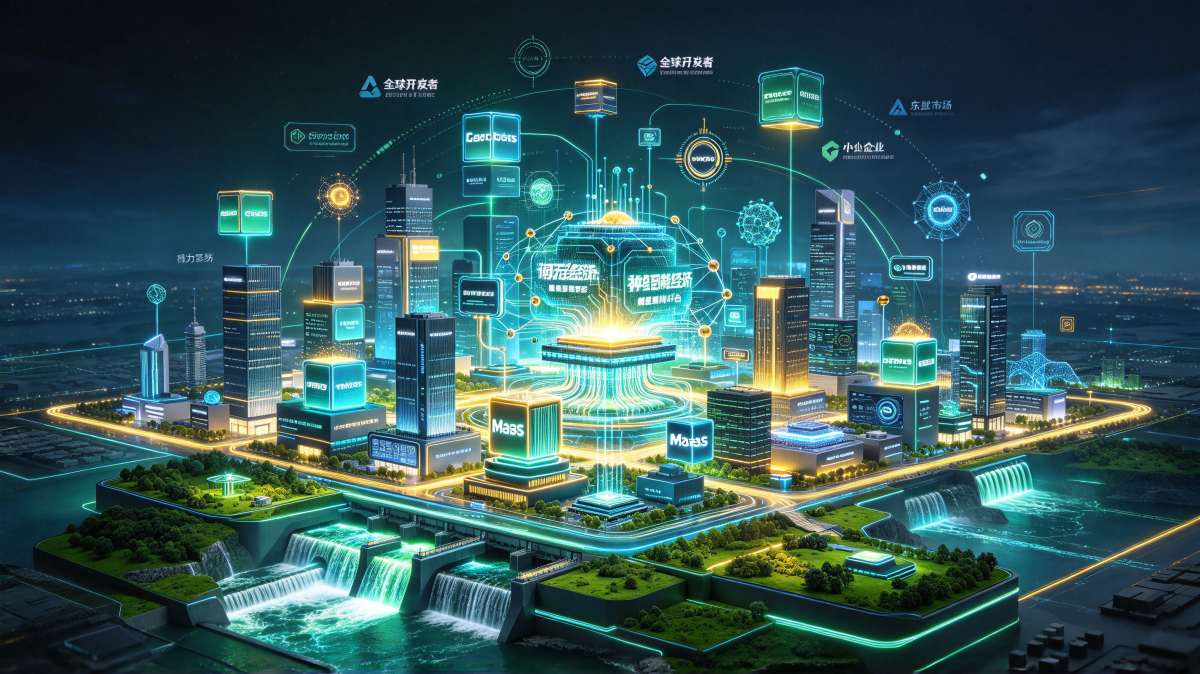
图片由AI辅助生成。
夯实本土词元产业底盘,统筹全区智算资源配置,做优词元工厂等本地算力企业,从严开展新增算力项目效益评估,避免盲目扩大规模带来运营风险。加快构建全区统一公共词元服务中台,汇聚国内主流开源及商用大模型能力,为政企提供标准化词元调用、轻量化模型公共服务。引进国内词元加工、MaaS解决方案服务商落地,扶持本土软件企业向词元应用服务商转型,补齐产业链中游缺口。同时聚焦大模型应用、多语种以及跨境数据合规方向引进高端人才,推动高校优化课程设置,深化校企联合实训,为拓展东盟业务筑牢产业根基。
广西应坚持先做强本土词元产业,形成先行示范之后,再稳步出海、辐射东盟市场。开展“来数加工”试点,研究制定跨境数据合规管理流程,探索面向东盟的词元跨境计量、计价、离岸结算试点机制,推动与东盟国家数字服务、数据安全规则开展对接互认。依托中国—东盟博览会、中国—东盟信息港论坛搭建产业合作交流平台,重点打造多语种智能翻译、跨境电商AI运维、东盟农业智能服务、跨境物流智能研判等标杆示范项目。同时,健全跨境词元业务全流程监管机制,稳步提升广西词元服务的东盟市场渗透率,建成国家级面向东盟的词元出海枢纽。
(广西壮族自治区信息中心规划投资咨询处 冯格雅)
视频由AI辅助生成 制作:广西云-广西日报记者 古秀芳 林娟
晚 岄
声影同驰,笔墨为枪,
融媒列阵,奔赴八方。
AI 拓展感知的边界,
信仰是不变的罗盘。
征途未央,
山河共望,
秉心追光,岁岁如常。
报纸版面截图。
广西日报创作团队:
主编丨龚文颖 李新雄
编辑丨林 娟
美编丨李 云
合辑制作团队:
融媒体编辑丨谢 穆 徐世杰
融媒体美编丨吕瑾莹
融媒体责编丨范钰铭 高雅 廖妮 冯芯然
总值班丨金凯乐 雷剑秋
点击下方图片进入专题
查看更多精彩内容
↓↓↓