AI参与“造AI”? StartLux 3天完成决策模型研发与验证



近日,上海人工智能企业StartLux(原点星辉)发布专用决策模型StartLux-Decision,并开放代码与模型权重。
据团队介绍,完成StartLux-Decision的研发与验证全程仅用3天,支撑这一速度的,是该公司正在建设的Auto Research方法。本次首批推出0.8B、2B、4B、9B、27B五档版本。
38项基准中31项超越Jev
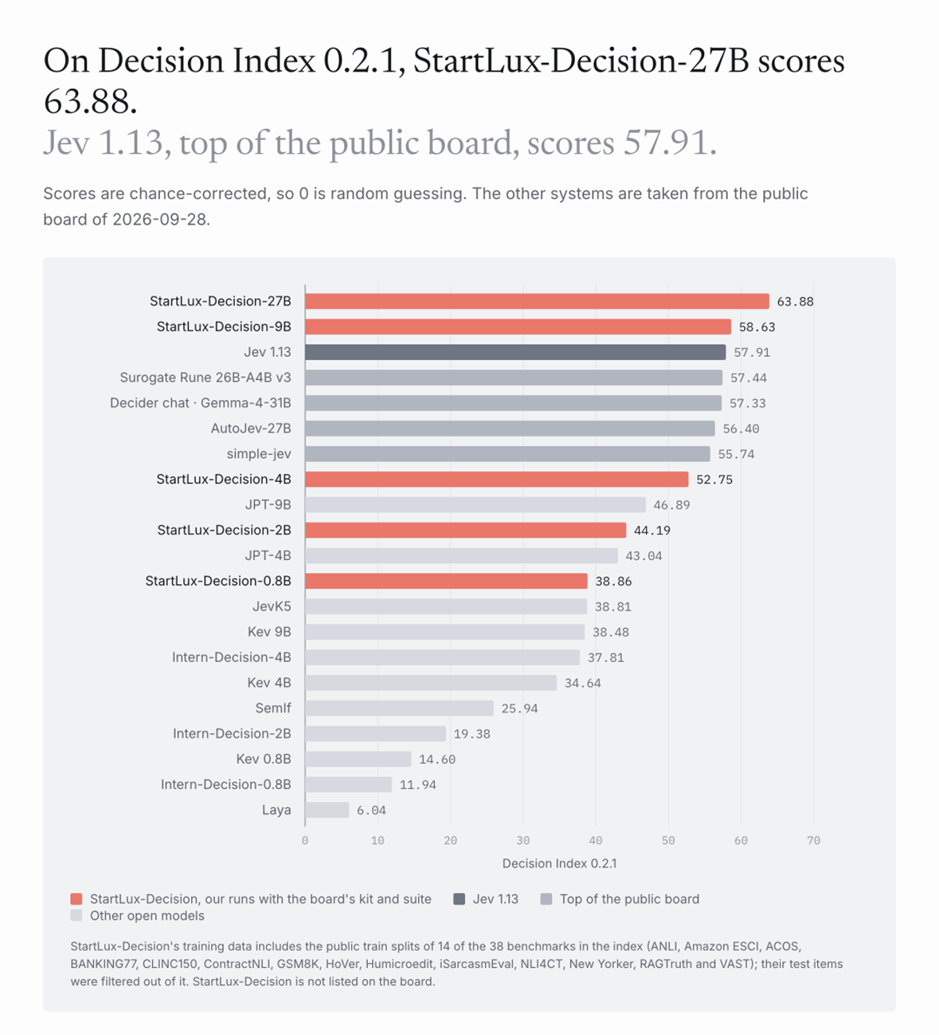
在StartLux公布的测评数据显示,在独立的Decision
Index 0.2.1评测中,StartLux-Decision-27B得分63.88,高于Jev 1.13的57.91;在38项基准中,有31项得分更高。对照采用2026年9月28日的公开榜单快照。
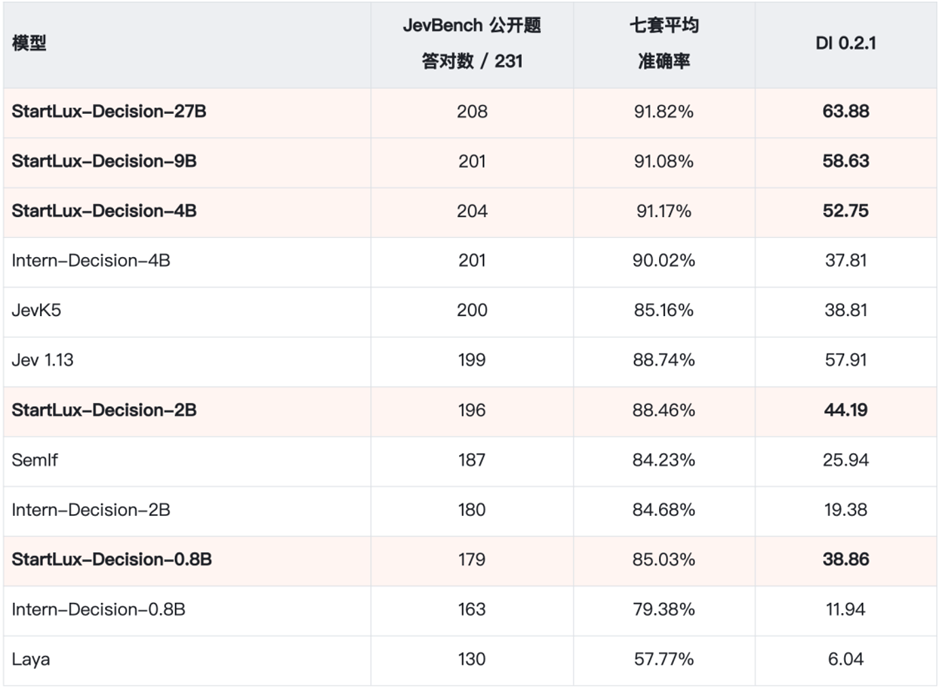
另一组参照,来自上海人工智能实验室发布Intern-Decision时采用的七项评测组合。在该组合中,StartLux-Decision的27B版本平均准确率为91.82%,高于Jev的88.74%和Intern-Decision-4B的90.02%。
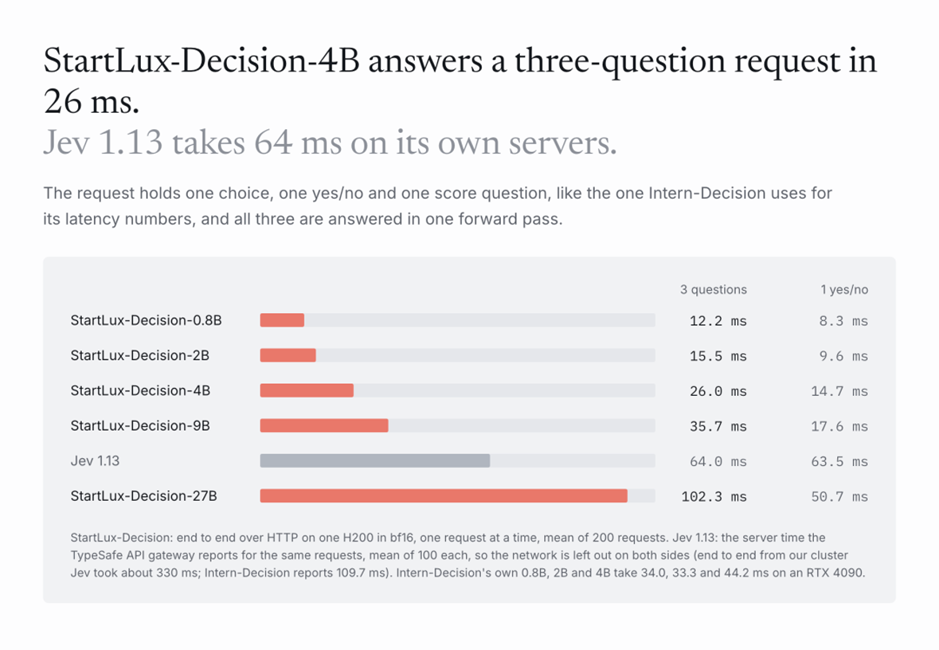
性能方面,在单张H200、BF16精度和短请求条件下,4B版本一次回答三个问题平均耗时26毫秒,0.8B与2B版本分别为12.2毫秒和15.5毫秒。测试通过本地HTTP进行,并启用快速计算内核与CUDA Graphs,测量的是请求响应时间。
让AI参与“造AI”
据团队介绍,决策模型瞄准的是智能体执行任务时大量重复出现的判断:下一步点哪个按钮、调用哪个工具、当前任务是否完成。这些问题的候选项往往已经明确,但每一步等待仍会累积,影响整体执行效率。
StartLux-Decision接收当前状态和候选项,支持选择题、是非题与等级评分。对于常规请求,它可以通过一次前向计算返回多个问题的判断及选项概率,无需逐字生成回答文本。
例如,同一条客服工单可以同时对应三个问题:应交给哪个团队、是否需要当天处理、影响程度如何。执行程序拿到结构化结果后,可以继续分流或操作;需要撰写回复、展开复杂规划时,则由通用模型接手。
让这套模型跑起来的,是StartLux正在建设的RSI(递归式自我改进)体系中的Auto Research环节。据团队介绍,它让AI参与“假设—实验—验证—新假设”的循环:分析上一轮失败、构造数据、执行训练与评测,再提出下一轮值得尝试的改进。在这一循环中,研究目标、评价标准和关键取舍仍由人类研究员把关。AI承担更多实验执行和分析工作,研究员则依据实际结果判断改动是否有效。
在此基础上,StartLux希望进一步提升AI提出假设、设计实验和验证改进的能力,使“改进AI”的能力本身也持续提高。此次StartLux-Decision的研发,是这套体系中Auto Research环节的又一次具体实践。
演示、开源与后续检验
在应用演示中,StartLux-Decision被接入模拟网店,完成商品筛选和下单;在《星际争霸II》中,为人族机器人选择建造目标、兵种优先级与攻防策略。模型提供决策,页面操作和单位控制由执行框架或脚本完成。
目前,StartLux已公开该决策模型的权重、相关代码和评测结果。Auto Research则仍作为公司内部的研发环节运行,此次对外发布的是这一流程产出的模型成果。
现有测试主要反映模型在公开基准和受控环境中的表现。它在更复杂任务中能否持续作出可靠判断,以及自动研究方法能否在更多项目中稳定带来效率提升,仍需通过后续实验和实际应用检验。
按照StartLux的技术路线,决策模型将与通用模型、智能体及运行时等模块协同,服务完整的本地智能解决方案。此次发布既为开发者提供了可使用的决策组件,也展示了AI参与模型研发的一次具体实践。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”