把摄像头戴在人头上,能解决机器人“数据荒”吗?



【文/胡祥熙 编辑/吕栋】
一个简单的动作,机器人要怎么学?答案是数以万计的真实操作数据。
全球可用真实物理交互数据仅约50万小时,连千万小时级训练数据的十分之一都不到。缺口就是市场。
2026年,Physical AI赛道的热度空前,上半年国内具身智能赛道融资总额超过935亿元,仅具身数据这一细分领域就吸走了约170亿元。
近百个数据玩家涌入赛道,七成在做采集。
但集中式数采工厂成本高昂,真机遥操单小时成本500到1000元,一套工厂的硬投入包括设备、操作员薪酬和场地三项,没有规模化订单摊薄很难自负盈亏。
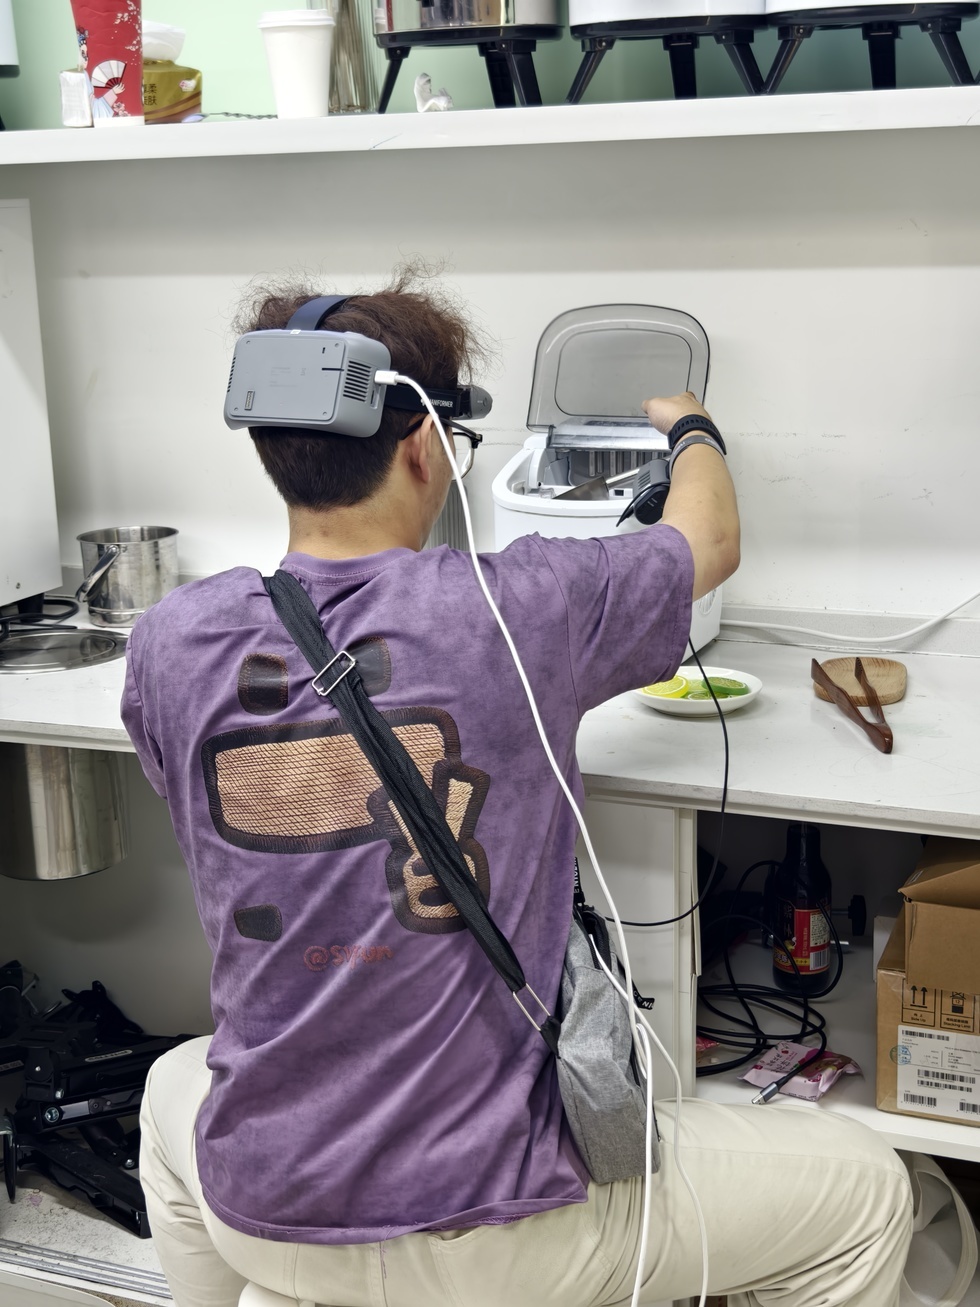
就在这种背景下,一种把摄像头戴在人头上的新路径爆发:普通人佩戴头戴式设备,在日常生活和工作中顺便采集第一人称视频数据,上传后按有效时长获取报酬,日薪120元到250元不等,成为机器人训练师。
全职宝妈、外卖骑手、退休老人......普通人头上戴着摄像头,日复一日地叠衣服、倒水、擦桌子、遛狗。他们采集的第一人称视频,正在成为机器人学习物理世界规律的教材。
这场全民数采运动轰轰烈烈地铺开,但问题依然悬而未决:把摄像头戴在人头上,真的能喂饱机器人的数据胃口吗?
从夹爪到手机,数据采集路线的急速转向
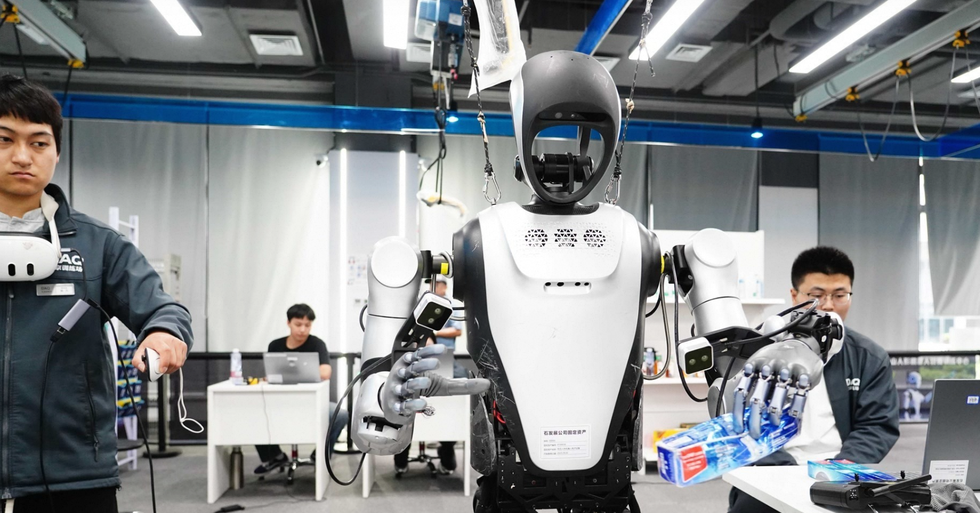
把时间拉回2025年。那时,数据采集还是一个存在于实验室和集中数采厂里的专业工种。在北京石景山首钢园,占地3000平方米的北京首个人形机器人数据训练中心里,100多台机器人被部署在家庭康养、汽车装配等十大实景场景中,工作人员戴着VR头显、手握夹爪,遥控机器人反复完成抓取、分拣等动作。这种真机遥操模式的成本极高,单有效小时成本在500至1000元区间。
2025年底,UMI通用操作接口路线从海外传入,用通用夹爪配合GoPro相机,让采集人员在真实场景中缓慢、标准地执行任务,成本有所下降,但夹爪操作门槛依然不低。
真正的转折发生在2026年3月。英伟达GTC大会上,EgoScale框架横空出世,用2万小时带动作标注的人类第一人称视频预训练,再加4小时灵巧手机器人实操数据微调,就让机器人学会了拧瓶盖、叠衬衫、转移液体等操作,成功率88%。这一结果颠覆了行业此前的认知:机器人不一定非得模仿机器人的动作,它可以观看人类做事的视频,从中学习物理世界的因果规律。
互联网上有万亿级token的文本语料,但机器人可用的真实物理交互数据全球满打满算不过50万小时;而训练一个具备泛化能力的具身大模型,业内主流观点认为至少需要1000万小时,要实现智能涌现则或许需100亿小时。
这个缺口决定了两个事实:第一,需求远超供给,头部客户的心态是即产即买,几乎不设数量上限; 第二,纯粹靠集中式工厂用真机遥操采集,根本填不上这个天文数字。
于是行业经历了三次迭代:最早是真机遥操,人通过VR设备操控机器人,重复执行任务,成本最高、精度也最高;随后是UMI路线,用通用夹爪配合相机记录操作轨迹,把机器人本体换成了廉价工具;再到如今的第一人称人类视频,普通人戴着头戴设备或直接用手机拍下日常操作,上传即完事。
每一次迭代,都朝成本更低、门槛更低、规模更大的方向跨了一大步。
这背后还有一条更深层的技术转向。早期业界主流的VLA路线要求数据像机器人一样精准,每个关节角度、每毫秒力矩都是标准答案,廉价数据的噪声会被模型放大到无法使用。
但从2025年下半年开始,世界模型路线迅速崛起,它主张机器人从海量人类第一人称视频中学习物理世界的因果规律,重力让杯子下落、不同力度拧瓶盖结果不同等等,再只需少量真机数据微调,就能泛化到未见过的任务上。
这一转向意味着数据可以“脏”一点、场景可以乱一点、操作可以不标准,只要够多、够真实、够多样,反而是好事。于是工具从精密夹爪降级为手机支架,采集要求从动作必须精准变为正常记录就好。
这正是头上长摄像头能站上舞台的技术前提。
目前,全球已形成一条清晰的众包采集产业链:普通人每天工作6到8小时,按有效时长拿到20到50元每小时的报酬;经过采集平台审核、标注、算法处理后,这些数据以200到400元每小时的价格出售给机器人厂商或模型公司,毛利甚至可达100%。
京东发动10万员工及外部50万各行业人员即戴即采;蚂蚁数科研发手机加颈挂式支架的AoE框架;纵横物理推出售价899元的数采AI眼镜。
这条赛道已经到了“战国时代”,每个月都有新方案替代旧方案。
“物理AI最好的老师,是每一个认真生活的人”
具体观察会发现,数采行业中的企业也在给出自己的答案。
9月23日,觅蜂科技董事长兼CEO姚卯青抛出了一个判断:物理AI最好的老师,是每一个认真生活的人。
据了解,觅蜂科技当天发布了全球首个全品类高质量物理AI数据众包服务平台“觅蜂派”。觅蜂派面向社会开放物理 AI 数据采集任务,用户通过觅蜂派App领取数据采集任务,佩戴 MEgo 设备在零售、仓储、制造、家庭等真实场景中完成指定操作,按照审核后的有效数据时长即可获得相应报酬,成为一名“机器人训练师”。
在发布会当天的一场对话中,关于数据缺口,姚卯青对观察者网等媒体表示,目前需求远大于供给,而且只会越来越大。
他提到,头部客户的数据需求已从去年的几十万小时跃升至千万小时级别,很多客户都已经到了预算1000万小时的水平。而要做到千万小时规模,需要几万套采集设备同时运转。但他同时认为这还不是终点,整个行业对数据的依赖变得越来越大,而且是在不断地往更大规模快速突进。
为什么增长如此迅猛?他解释,随着行业从VLA模型向世界模型乃至世界推理模型演进,对真实世界数据的需求只会成倍放大,这是不可逆的趋势。
关于众包模式的核心竞争力,姚卯青给出了一个反直觉的回答:真正难的不是技术,而是运营。他指出,这个赛道不太适合几个人出来创业,融了几百万、一千万就能把这个事规模干起来。要应对千万小时级别的数据需求,需要大几个亿固定资产投入,设备生产制造、人员雇佣、云端基础设施,每一环都是重资产。
姚卯青提到,快速规模化运营人、运营场景、运营设备的能力才是真正的门槛。行业资源极度摊薄后,整合是必然,未来会出现明确的分工,有的公司做硬件,有的做运营,有的做后处理技术服务。
关于数据质量,贯穿姚卯青观点的一条主线是数据质量分层理念。
他表示,行业不能把数据简单分成好和坏两类,而是应该给数据贴上不同质量标签,让不同模型、不同阶段的训练各取所需。在觅蜂派的操作中,结算环节之后超过95%的数据最终能被用起来,而不是简单丢弃,这在行业内是极高的利用率。
针对外界对第一人称视频到底有什么用的疑问,姚卯青给出了清晰的定位:Ego数据不是针对单任务Demo优化用的,而是在大模型、世界模型的预训练阶段,用来提升基础模型的零样本泛化能力。小数据量时效果不明显,但到百万、千万小时级别后就会逐步涌现。真机数据则用于后续的动作适配、部署验证和数据回流,两者是分层互补的关系,而非替代关系。
关于商业模式,姚卯青的回答中提到:即使单次出售,也已经有比较好的毛利率。他算了一笔账:采集侧通过众包让普通人在日常生活中顺便采集赚补贴,成本结构优于专职雇人;后处理侧从标注、切分到空间信息提取,所有模型全部自研,数据量越大,模型效果越好,人工占比越低,自动化程度越高,形成正向飞轮。叠加数据可多次销售的商业模式,他明确表示商业上是可以打正的。
答案或许不只是能或不能
回到最初的问题:把摄像头戴在人头上,能解决机器人的数据荒吗?
从数字上看,众包模式确实正在突破集中式采集的产能天花板。觅蜂派内测仅一个月,注册用户已突破2万,累计产生1.3万份采集任务提交; 其MEgo设备已于8月底下线第20000套,累计生产超100万小时的真实世界无本体数据。 姚卯青测算,1万台设备一天工作十多小时,产出4小时有效数据,一年250个工作日,就能产出1000万小时,这个量级已经可以满足头部客户的年度需求。
而且这种模式的商业可持续性正在被验证。即便单次出售已能实现较好毛利率,数据还能反复多次销售给不同客户,降低行业和社会的重复造轮子的成本。
但硬币的另一面同样不容忽视。
科技树的方向仍在摇摆。世界模型路线让脏数据变得有价值,但这不等于说所有脏数据都有用。业内尚未形成统一的仿真数据质量验证公共基准,Sim to Real的虚实差距依然存在。
真实世界的操作经验成为最稀缺的训练资源,众包确实提供了一个从10万小时到1000万小时乃至100亿小时的可操作路径。但路径终归只是路径,不是终点。数据是土壤,但种子,也就是世界模型、VLA架构、物理仿真引擎,才决定这片土地上能长出什么。
把摄像头戴在人头上,能缓解数据荒。但要真正解决数据荒,还需要更多:行业标准的统一、数据质量的闭环验证、商业模式的真正独立,以及那个所有人在等待的具身“GPT时刻”的到来或不来。
在当下,这个答案还没有人真正写出来。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”