当数据有了“身份证” 人工智能发展补上关键制度“拼图”
近日,我国首批数据产权登记凭证正式落地,一批市场主体拿到数据持有权、使用权、经营权的有效证明,不少面向大模型训练的行业数据集完成产权登记。这张被称作数据“身份证”的凭证,并非简单的确权文书,它直面人工智能产业上游的核心堵点,是我国在全球AI竞争格局下,对数据要素规则的一次重要制度探索。
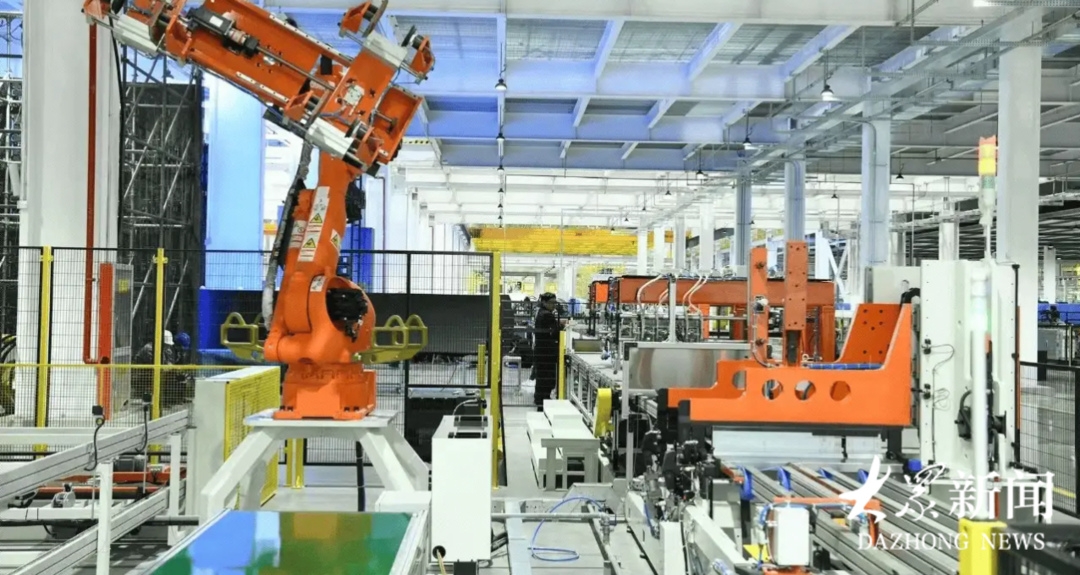
当下人们看待人工智能竞赛,大多聚焦于算力芯片、模型参数、算法创新这些显性指标。但拨开技术表层,大模型的迭代,本质是一场高质量训练数据的持久战。算力可以持续扩建,算法能够持续调优,可优质的行业语料,无法靠短期投入凭空制造。没有合规、高质量、可规模化流通的训练数据,再强大的算力硬件也只是空转的机器。
近几年,AI产业发展的现实困境之一,就是海量高价值数据沉睡在各行各业的业务系统中。从工业制造、医疗健康到城市治理、交通物流等,大量经过实践校验积累的垂直领域数据是训练行业大模型最宝贵的养料,可长期以来,权属边界模糊等问题让数据陷入两难困局。一方面是手握数据的企业与机构不敢轻易对外开放数据集:一旦授权给AI企业用于模型训练,那数据的使用范围、收益归属、侵权风险等方面是否会产生纠纷甚至影响未来发展?另一方面,大模型企业同样处境尴尬,想要构建垂直领域的专业能力,仅依靠互联网公开抓取的文本信息远远不够,这些数据往往良莠不齐,存在大量错误、冗余信息,很难直接用于专业模型训练。这造成一种错位:一边是海量数据“沉睡封存”,一边是AI企业苦于缺少高质量训练原料。最终,不少大模型通识能力表现亮眼,但一旦落地到真实场景,总是“水土不服”。
放眼全球,AI训练数据的规则博弈早已暗流涌动。2023年12月下旬《纽约时报》对OpenAI的语言模型LLM、ChatGPT以及微软由GPT-4驱动的必应聊天工具Bing Chat提起诉讼,指控微软和OpenAI逐字逐句地复制了《纽约时报》的内容,并经常将虚假信息归因于《纽约时报》。而近年来,国外时有头部大模型企业陷入大规模版权诉讼,过去那种无差别抓取网络内容作为训练素材的粗放模式,正在被司法体系不断约束,无偿收割数据的发展路径已经难以为继。欧美各国也在通过立法修订、司法判例,重新划定AI训练使用数据的权利边界。全球AI竞争,已不只是技术层面的较量,更是一套要素分配规则的比拼。单纯依靠技术追赶,却缺少适配AI时代的制度底座,即便短期可实现模型能力的快速迭代,长期也会受制于数据供给的制度瓶颈。可以说,谁能更快更早建立起清晰、可落地的数据确权、流通、收益分配机制,谁就能构建起可持续的数据供给体系。
首批数据产权“身份证”的出台,是瞄准这一现实矛盾的制度破局。登记凭证厘清数据持有、使用、经营三类权利的边界,让原本无形的数字资源,拥有了可以被市场认可的法律载体。
站在数据供给方的视角,确权登记改变了过去数据“有价值、难变现”的局面。完成确权后,数据集不再只是存储在服务器中的数字资产,它可以对外授权模型训练,可以作价入股、开展融资担保,数据产出方能够从人工智能产业的发展红利中获得合理回报。正向的利益激励一旦建立,将能引导更多市场主体愿意投入资源去整理、清洗、打磨高质量数据集,推动数据开放从过去的政策驱动,逐步转向市场化、自我造血的发展模式。
站在AI开发企业的角度,经过确权登记的数据集,来源可追溯、权责划分清晰。企业在使用这类数据开展模型训练时,能够大幅降低版权侵权的合规风险,不必长期游走在法律灰色地带。这为产业大模型发展打开了新空间,也为垂直行业模型的培育提供了合规的原料来源。
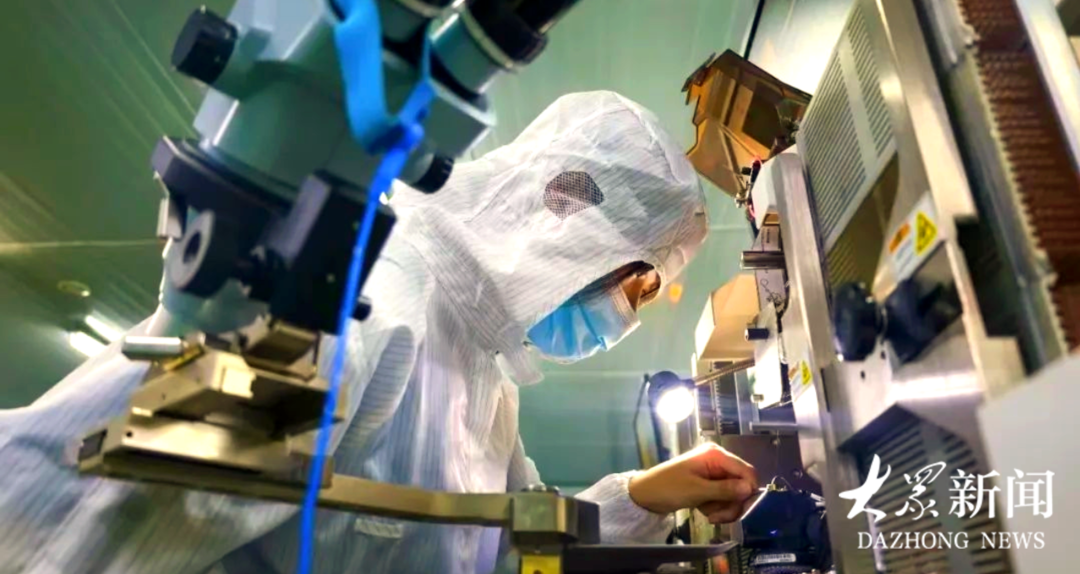
近年来,山东在推进“晨星工厂”的过程中同步进行企业数据要素化试点摸底,遴选“晨星工厂”中的佼佼者探索数据要素化、价值化的具体路径。以济宁碳素集团为例,作为数据资产化综合试点企业之一,选取工艺曲线、质量管理、供销需求等部分数据资源,逐步实现计量、入表、交易流通等,通过试点,一方面强化数据的交易流通,加强数据驱动业务发展的深度和广度,另一方面是作为碳材料行业龙头企业,期待率先摸索出一种数字赋能的解决方案在行业内推广。2024年,财政部发布的《企业数据资源相关会计处理暂行规定》正式实施,明确数据的资产属性及入表的适用范围、会计处理使用准则、列示和披露要求。如今数据产权登记凭证又正式落地,相信会有越来越多企业涌入数据产业赛道,试水数据资产相关的更多样的业务。
不过,也应意识到,数据产权登记并不是一剂可以解决所有问题的万能药。确权解决的是“数据敢不敢拿出来流通”的制度入口,完成确权登记,只是整个链条的起点。登记之后,还有大量现实难题等待市场实践去破解。
如,数据集的质量评判标准、多方参与下的收益分配机制、数据交易的定价体系,以及数据安全、个人信息保护的底线约束等,这些无法凭借一纸确权证书就全部解决。又如,医疗、交通、社保等一些领域,行业数据集天然带有大量个人信息,如何在激活数据要素价值的同时,防范数据滥用、泄露风险等,仍是制度落地过程中长期需要关注的课题。
回望过往许多产业的成长过程,产业实践提出命题,制度供给回应命题;制度划定发展边界,产业检验制度成效,二者在持续试错、动态调试中协同演进。合理的制度供给能降低交易成本、厘清权益边界、平衡创新与安全,为产业释放发展空间,引导资源向合规方向集聚,塑造产业长期演化路径。数据产权“身份证”,本质上是搭建一套适配人工智能时代的利益分配规则:让贡献数据的主体获得应有的回报,让开发模型的企业拿到合规可用的训练原料,推动整个AI产业告别过去粗放攫取数据的发展老路,走向更加健康可持续的迭代路径。
人工智能的竞争,从来不是单一技术点的比拼,而是算力、算法、数据要素、制度规则构成的综合较量。当越来越多沉睡的行业数据拿到属于自己的“身份证”,高质量的语料能够有序流入模型训练体系,人工智能产业,才能逐步筑牢向上生长的底层根基。
(大众新闻记者 付玉婷)